基于A2A的SmartVoyage旅行智能助手
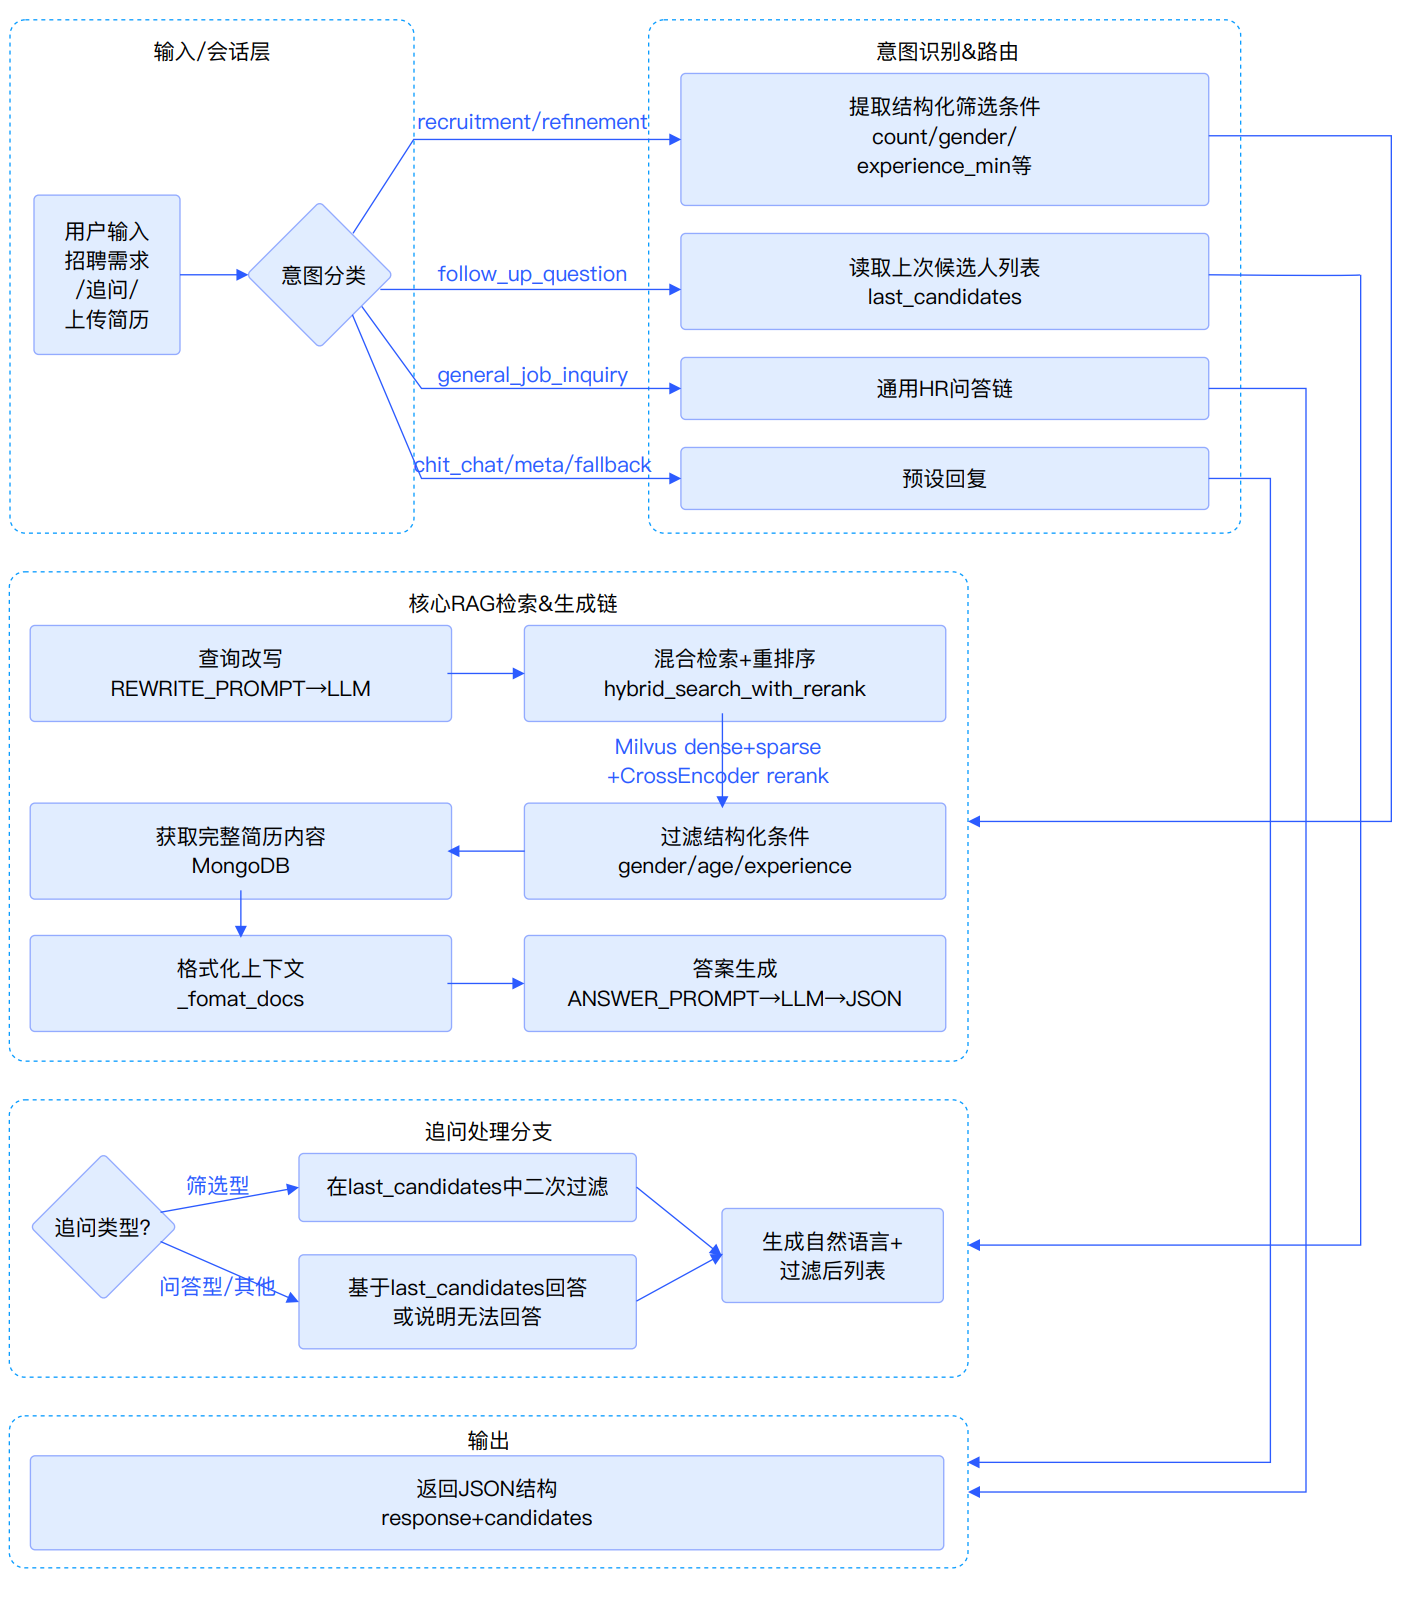
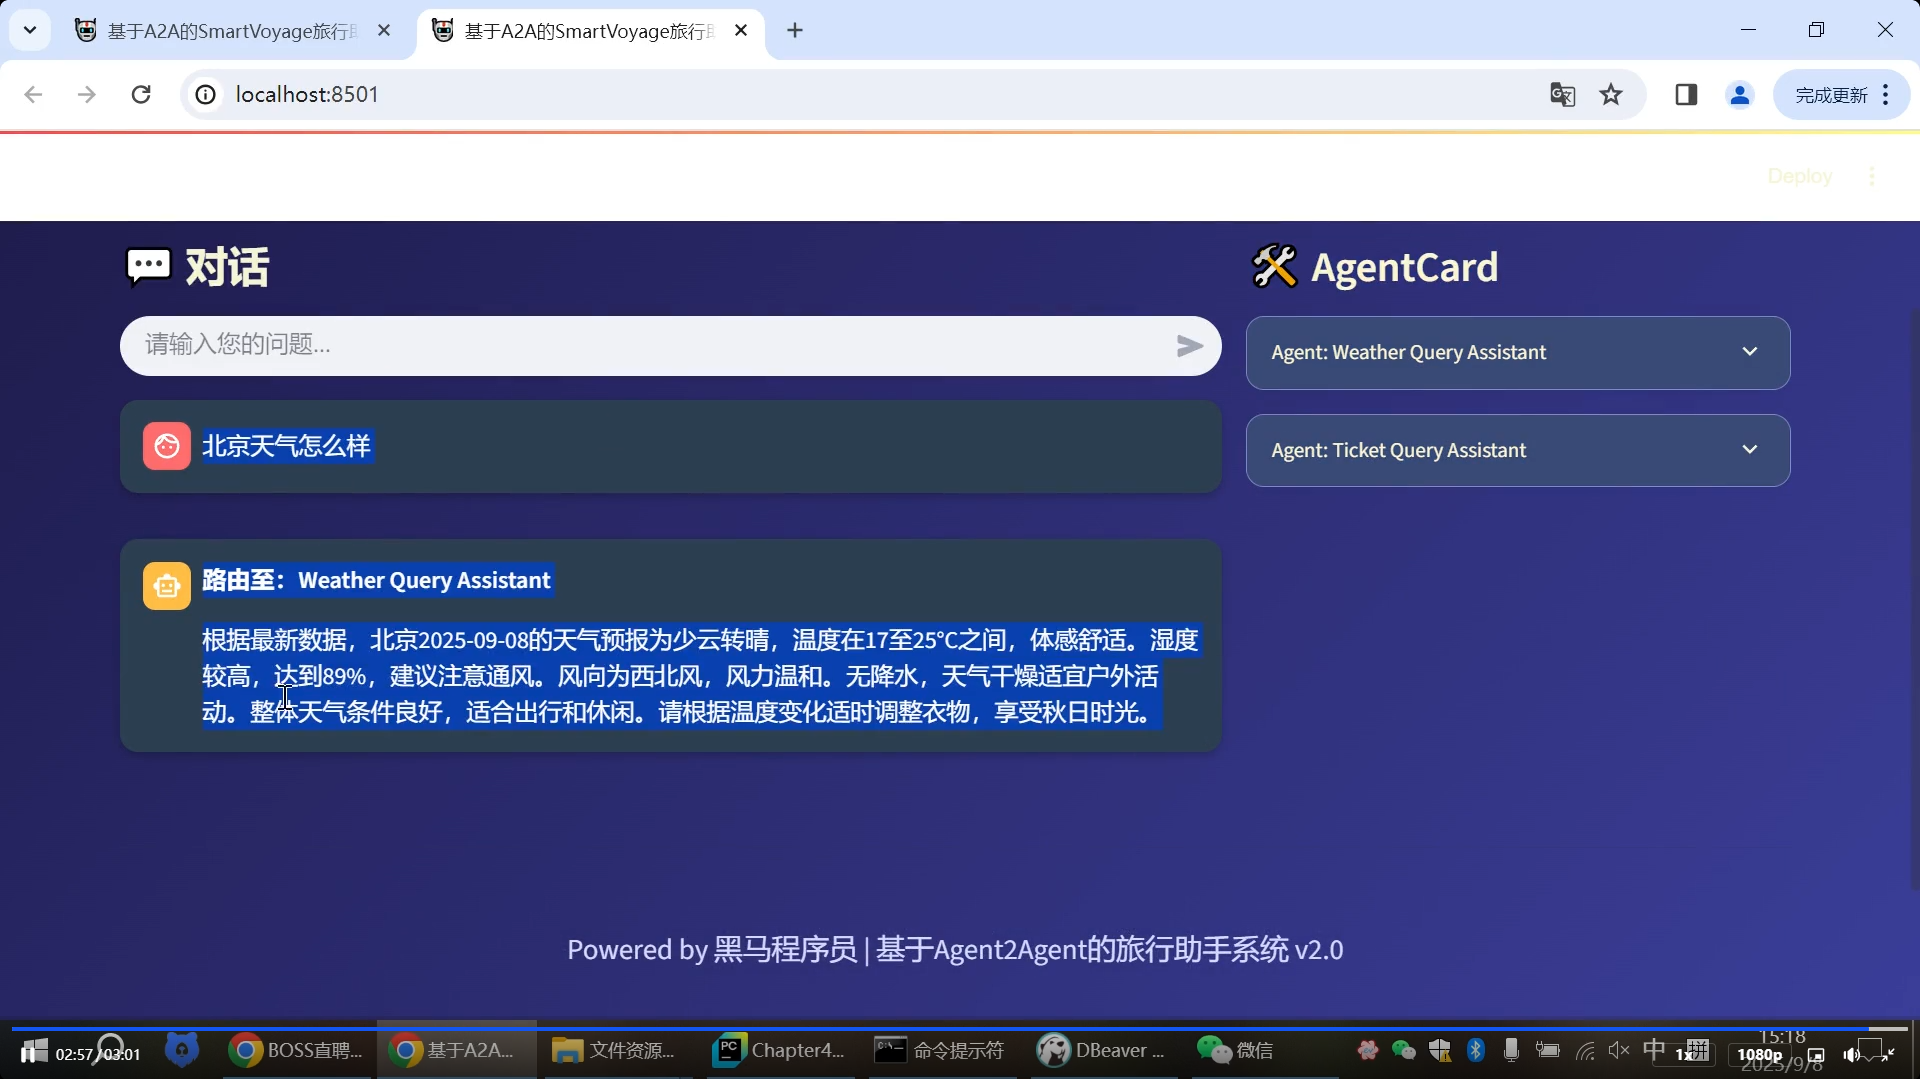
SmartVoyage 是一个智能旅行助手系统,使用 A2A (Agent-to-Agent) 协议构建多代理协作框架,支持用户查询天气和票务信息。系统包括 LLM 路由服务器(意图识别)、天气代理服务器(查询天气数据库)、票务代理服务器(查询票务数据库)、MCP 工具服务器(数据库接口)、数据采集脚本和 Streamlit 前端客户端。用户输入查询(如“北京天气”或“北京到上海火车票”),系统通过 LLM 路由到合适代理,代理生成 SQL 查询 MCP 数据库,返回结果显示在界面。
可掌握的核心能力
掌握 A2A 多代理框架开发
掌握意图识别与数据库查询技能
能够完成交互式旅行助手系统的构建
技术亮点
基于Python-a2a协议实现多代理A2A协作框架
使用LangChain+DeepSeek构建LLM路由服务器意图识别与动态路由
实现MCP工具服务器标准化MySQL查询接口
天气代理服务器LangChain SQL生成与MCP实时天气数据库查询集成
票务代理服务器多类型动态SQL生成与结果友好格式化
基于Streamlit开发A2A多代理实时交互前端客户端
技术架构图
SmartRecruit简历推荐项目
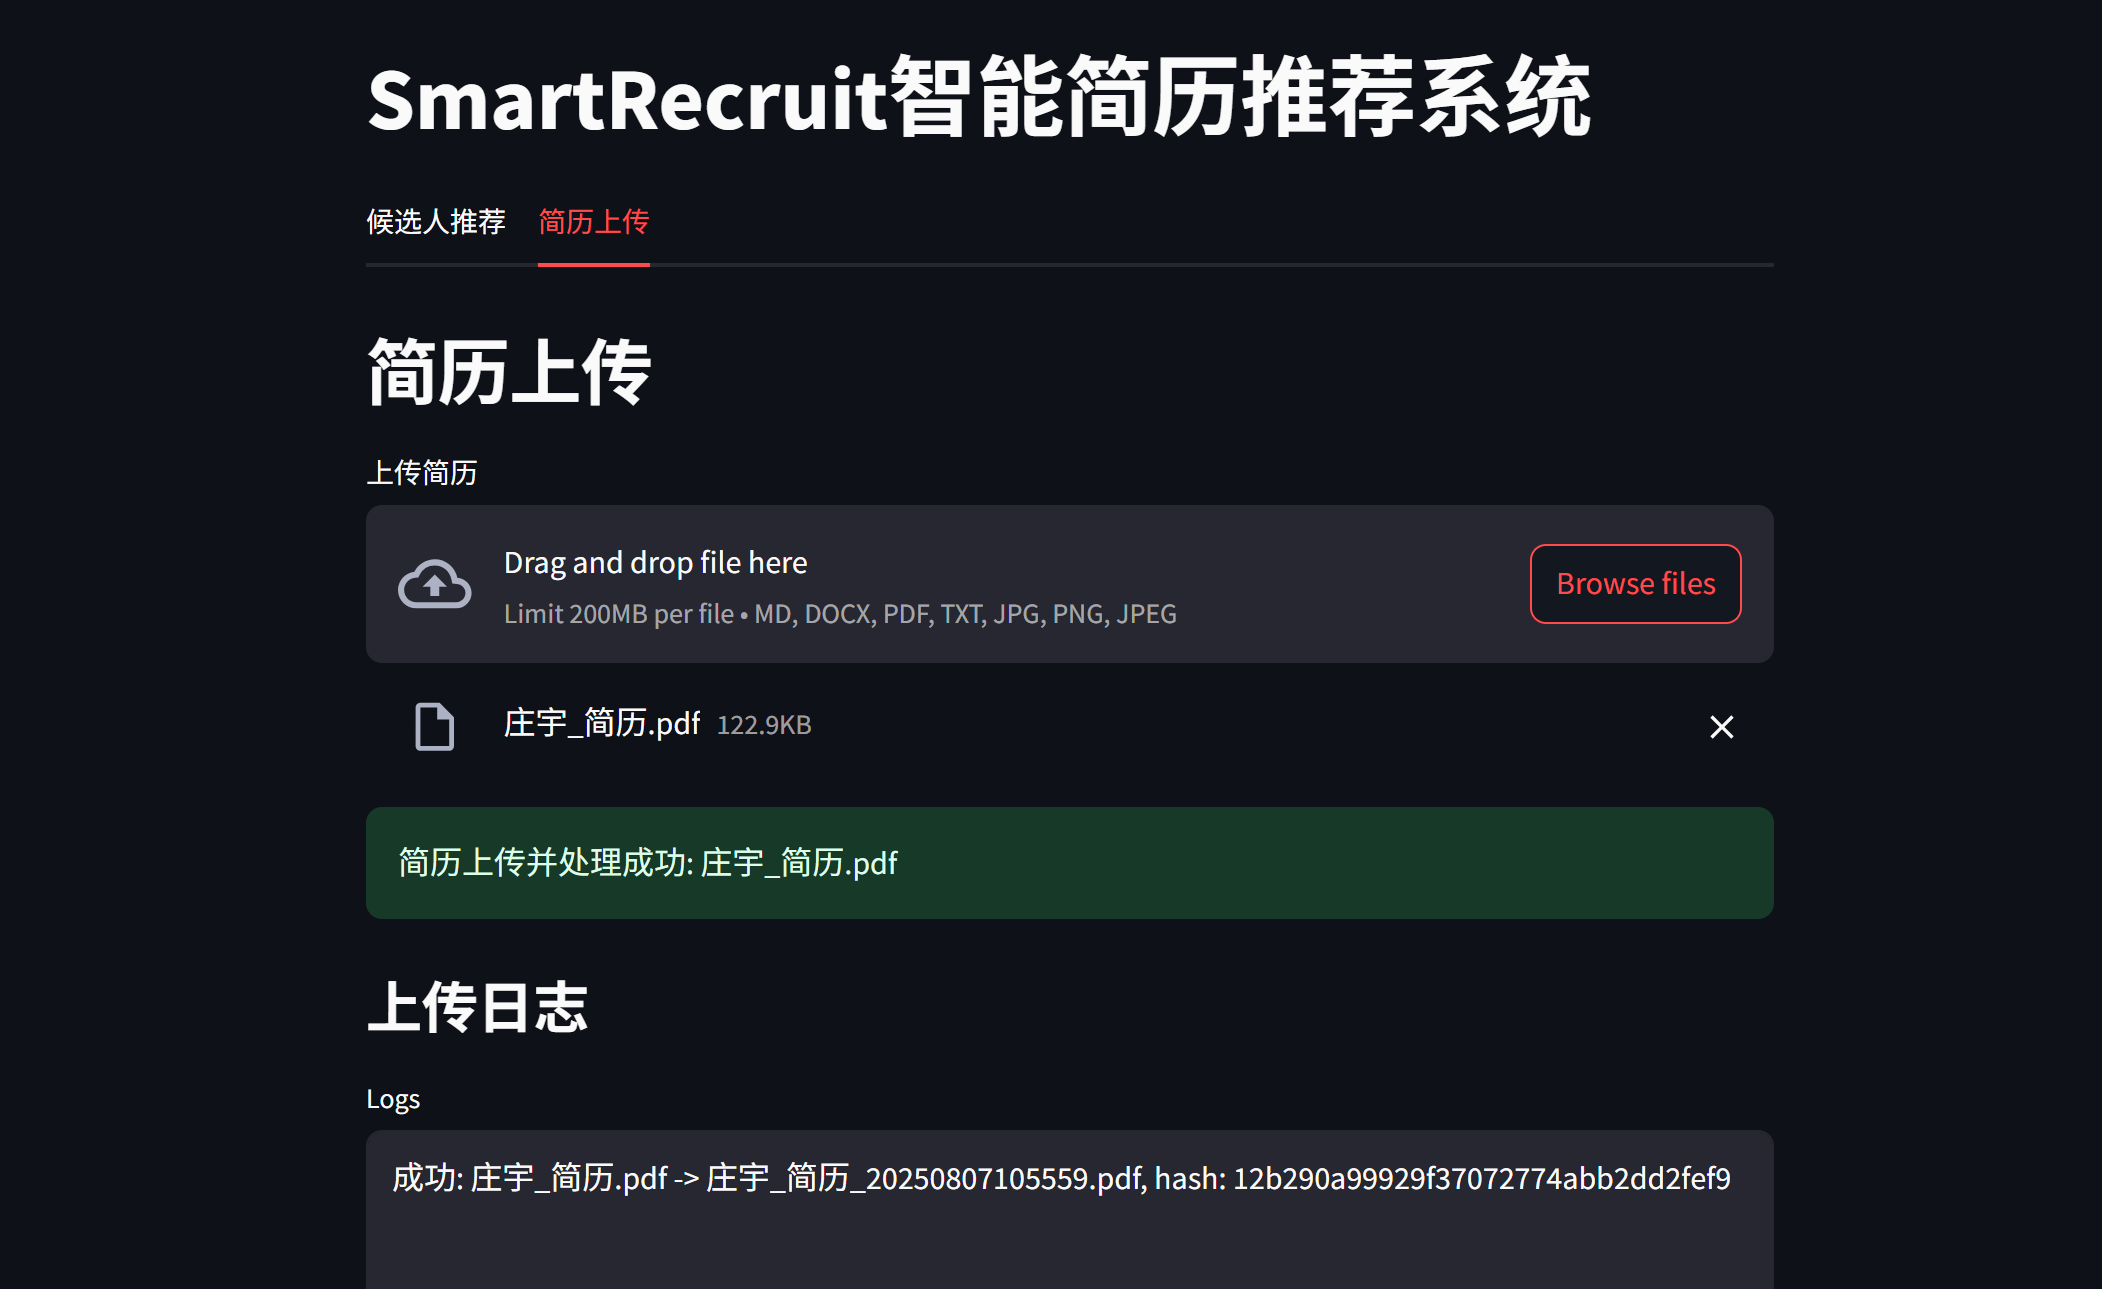
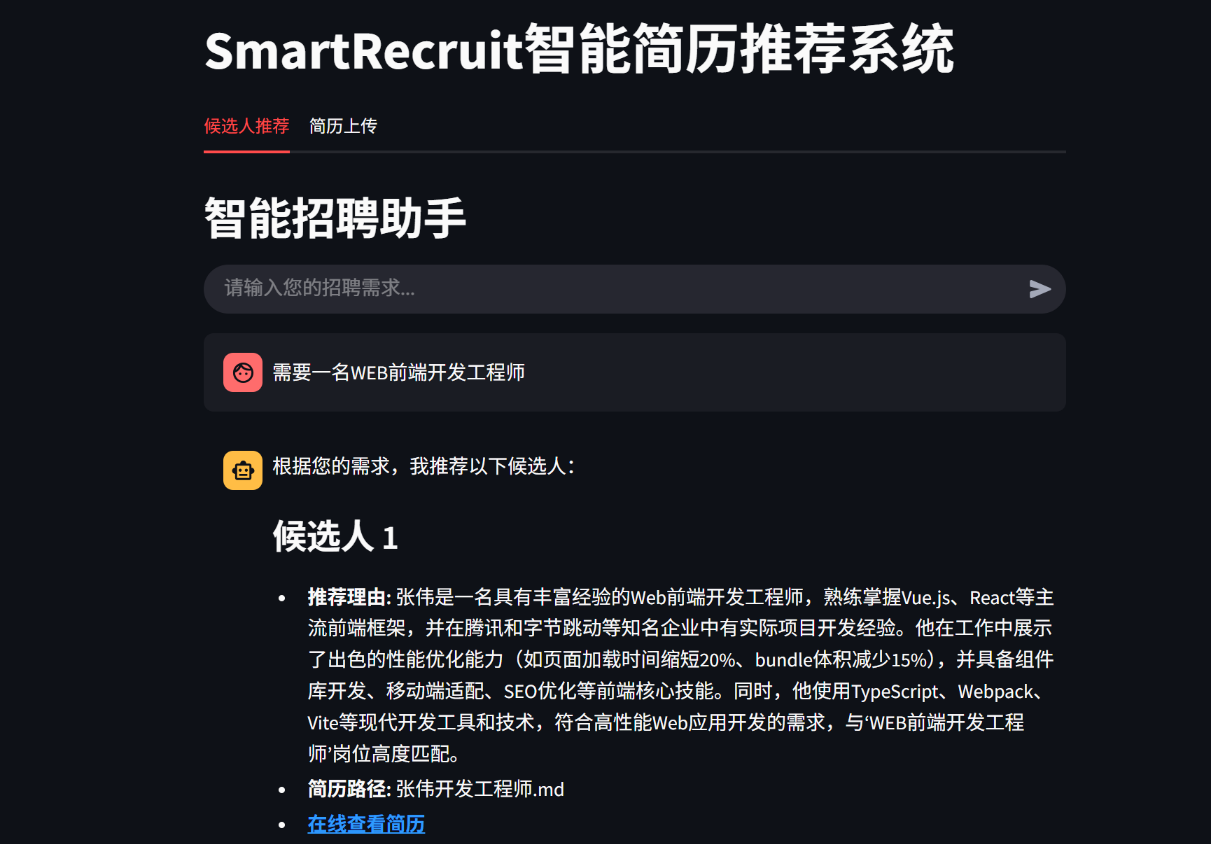
项目基于向量数据库和 LLM 构建一个端到端、可水平扩展的检索增强生成(RAG)系统,支持对异构简历(PDF/DOCX/JPG/PNG)进行自动解析、结构化、语义索引与多轮对话式推荐。系统以向量数据库为核心存储,以 LLM 为推理中枢,以 Agent 框架为调度单元,面向企业 HR 及猎头平台提供秒级、可追溯、可解释的候选人推荐服务。
可掌握的核心能力
掌握文档智能处理、向量化索引
掌握RAG 系统开发及 Agent 框架应用
能够完成可扩展的简历推荐系统部署
技术亮点
基于LangChain+OpenAI实现异构简历(PDF/DOCX/JPG/PNG)智能解析与结构化提取
使用Milvus+BGEM3混合嵌入+ElasticSearch实现高级向量索引与多路召回
构建支持参数过滤、查询重写与历史对话的异步RAG链生成JSON候选人推荐
基于SmartRecruitAgent框架实现意图识别、多轮追问与上下文候选人筛选的智能代理
集成Streamlit前端与Milvus/MongoDB/Elasticsearch多数据库持久化的DevOps配置
使用Ragas框架对RAG系统进行端到端Faithfulness/Answer Relevancy/Context
Precision评估优化
技术架构图
Coze智能面试助手开发
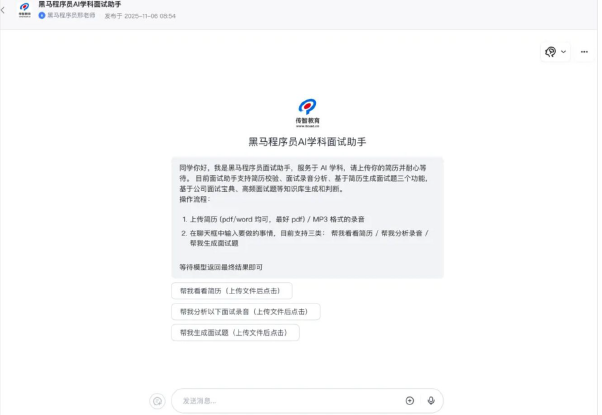
基于Coze工作流平台,结合LLM、ASR、TTS、RAG等技术,为黑马程序员AI学科学生构建面试全流程智能辅助系统,实现简历修改、面试录音分析、个性化面试题生成和实时语音模拟面试等功能。
可掌握的核心能力
掌握Coze智能体开发范式
能够独立完成多场景智能体应用的构建与部署
能够实现工作流自动化与业务赋能
技术亮点
实现基于插件完成PDF、DOCX等文档转文本到分析处理的全流程解决方案
实现基于ASR技术实现录音文件转文本到分析处理的全流程解决方案
实现基于知识库结合PDF实现精准内容生成的解决方案
实现在工作流中读写数据库和知识库的解决方案
实现父子模式多Agent架构自主规划执行解决方案
技术架构图
云客服*工业级智能服务平台
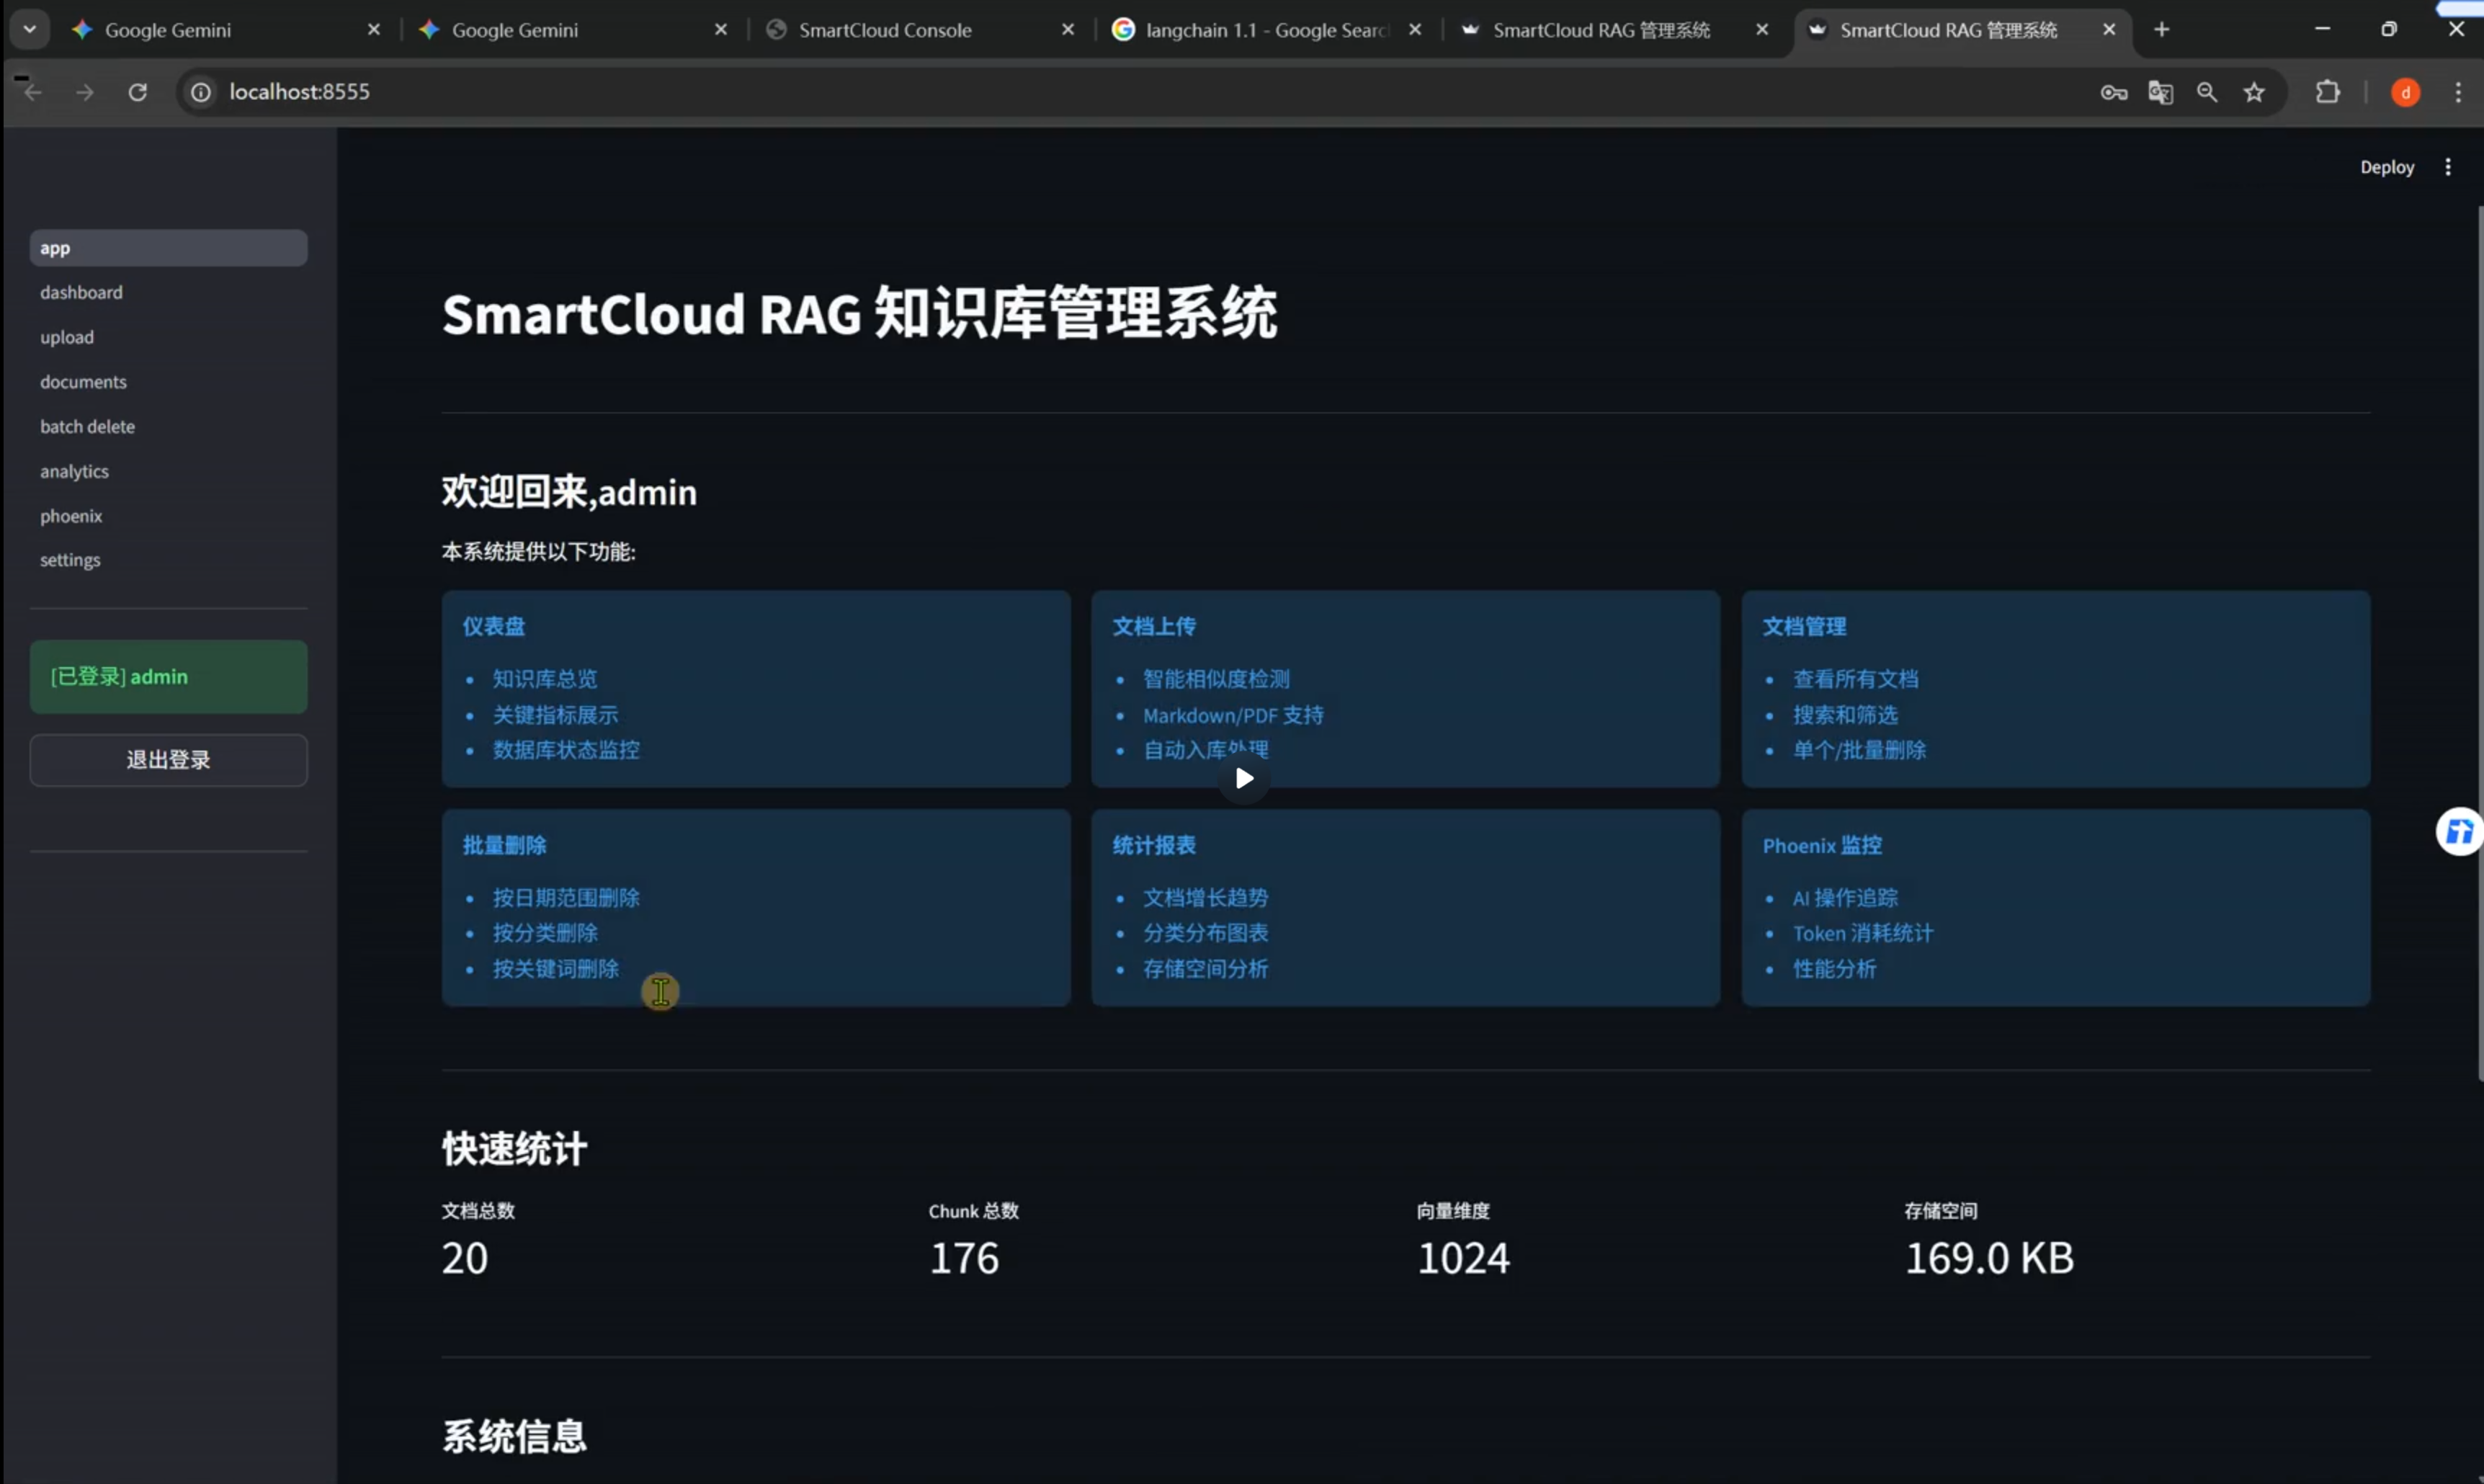
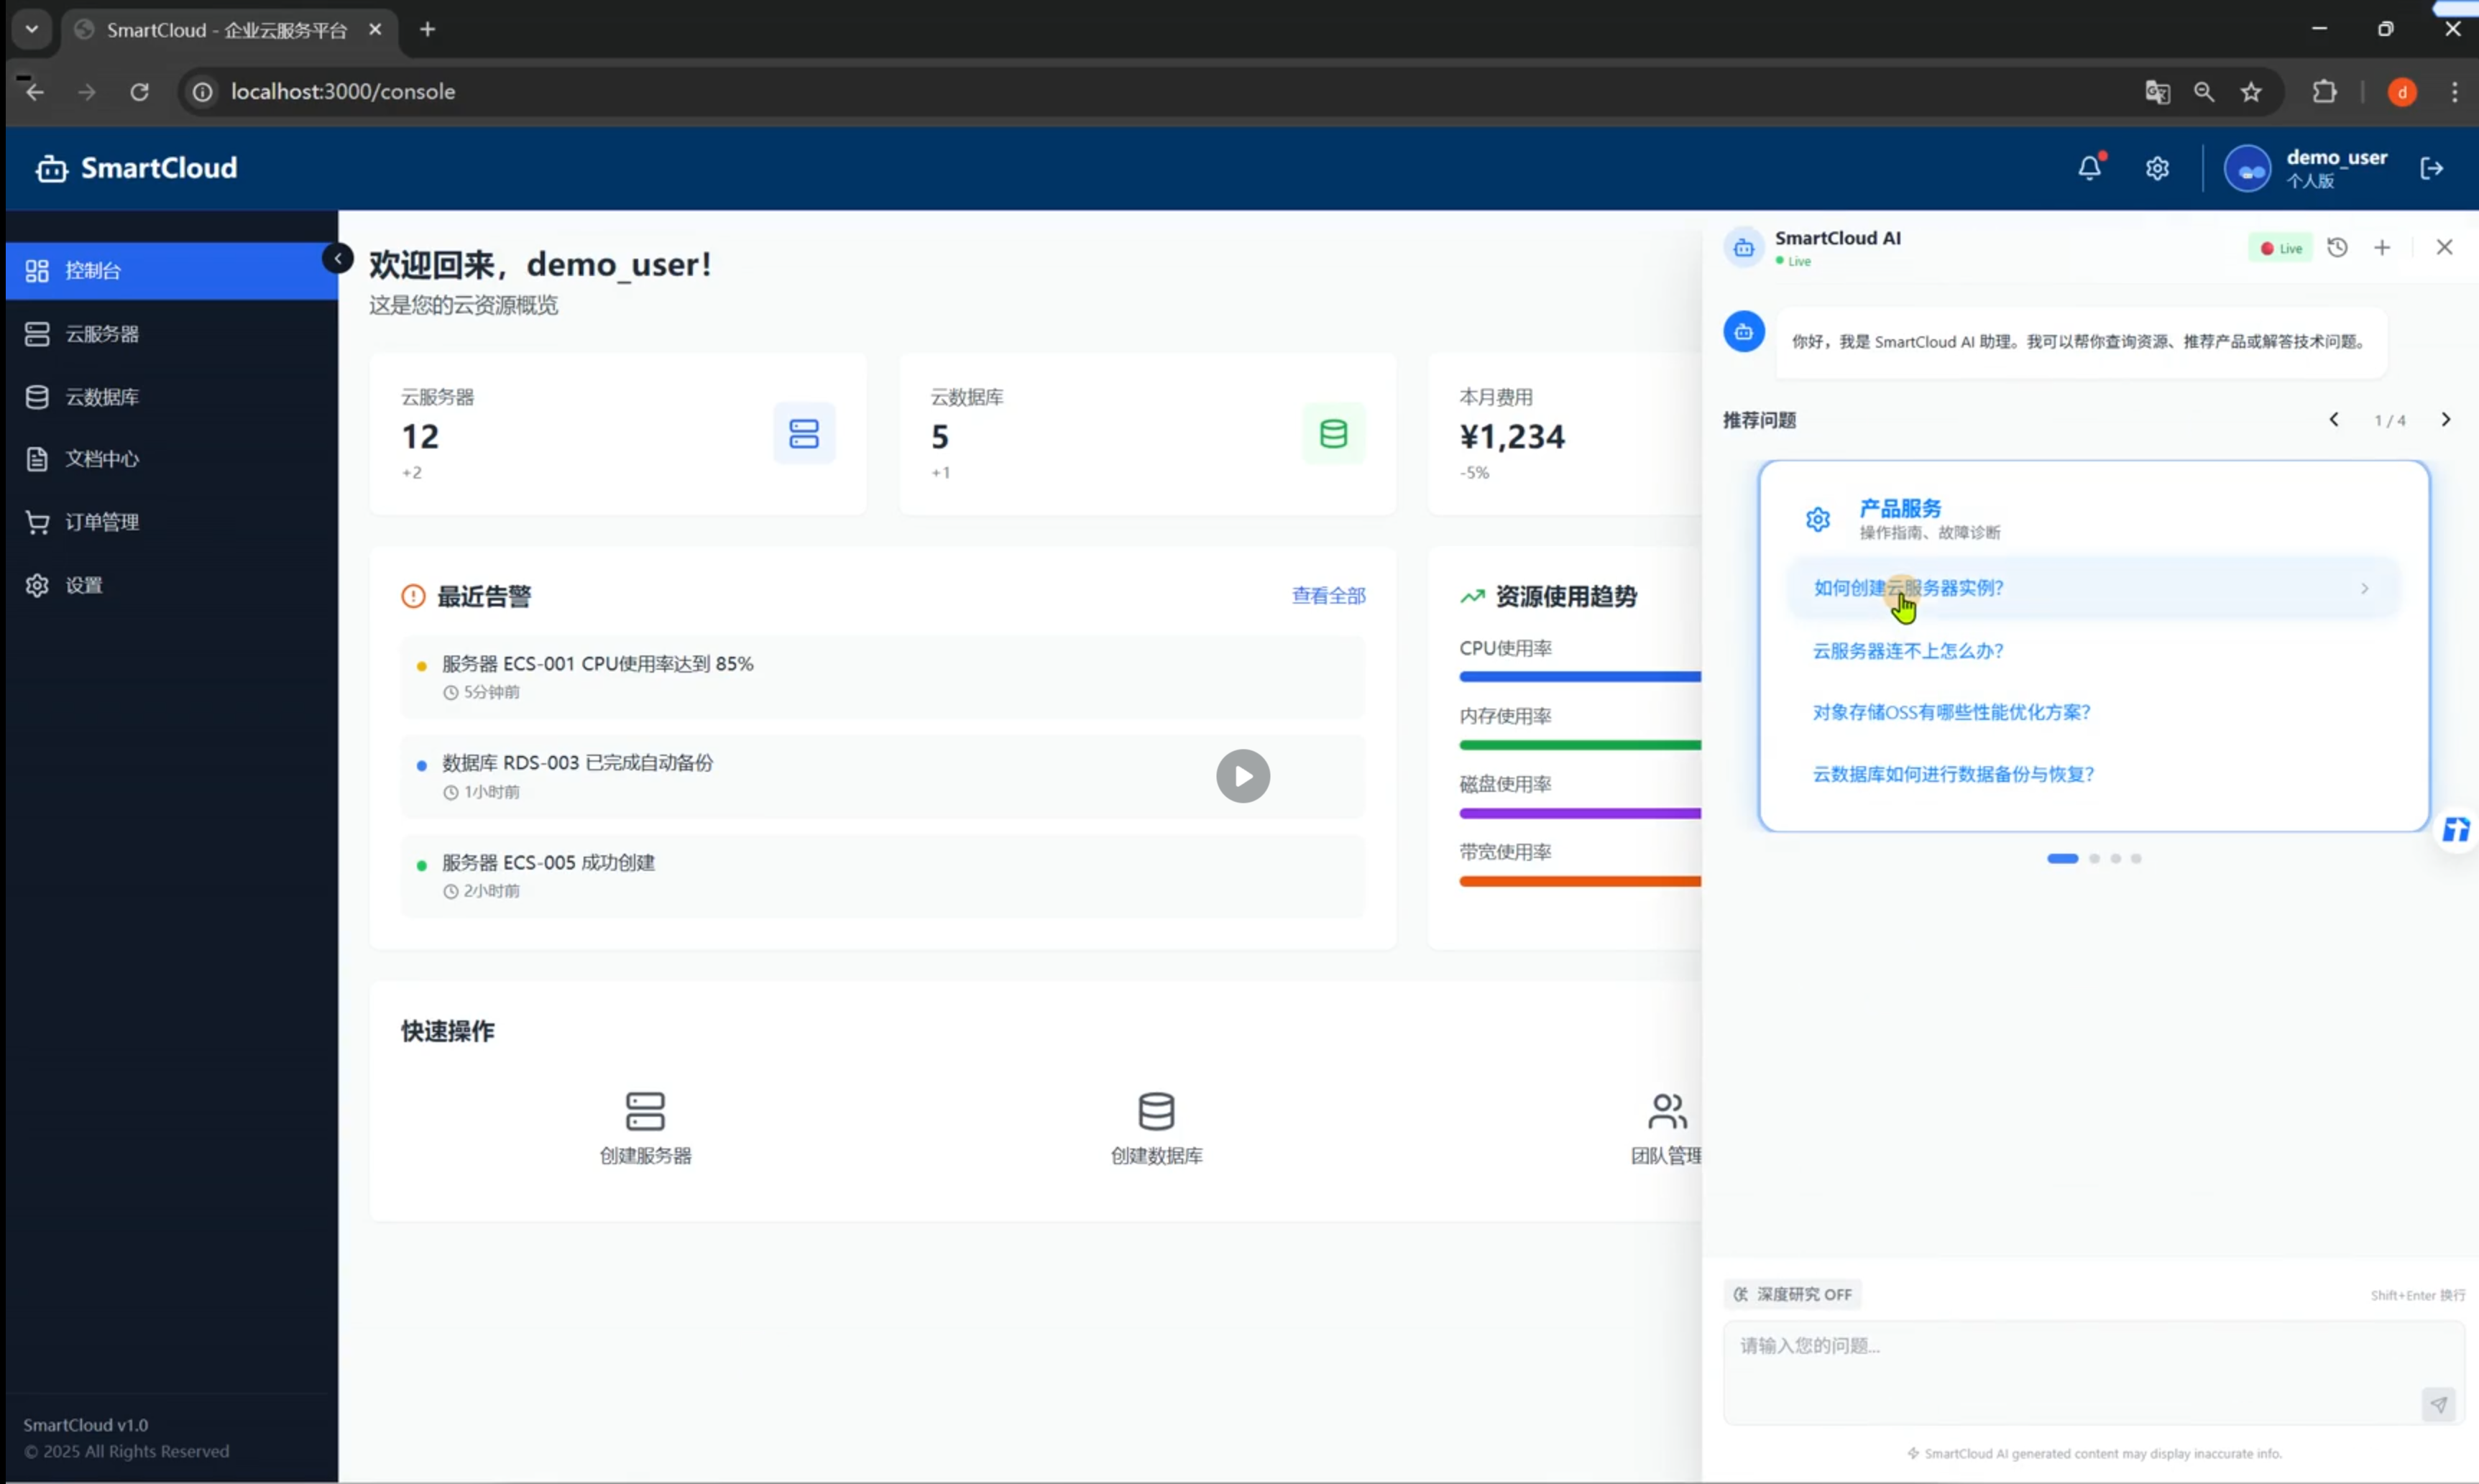
大型ToC企业中的客服团队往往是人力外包,对公司业务细节的了解程度不够,需要和产研团队多次沟通才能完成一次工单的处理,效率低下。 同时,随着AI的发展,工单的处理也可以基于大模型+RAG+funcation call能力进行提效,部分工单自动处理,从而节省部分客服人力资源。 本系统结合大模型能力,融合多种AI技术(RAG+多Agent+MCP)等,结合Kafka消息队列、PostgreSQL向量检索和Docker容器化部署,完成大型企业工单的判定、处理、建议与知识库实时迭代等全流程流转闭环,解决传统客服流程低效问题。
可掌握的核心能力
掌握企业级智能工单系统架构设计
能够实现基于规则过滤、查询改写、意图识别的全流程自动化处理
能够具备复杂业务场景下多智能体系统的开发与运维能力
技术亮点
使用无侵入的方式实时处理业务系统数据的解决方案
实现企业私有化数据脱敏的解决方案
实现基于多层模型实现复杂分类的解决方案
实现基于RAG+MCP调用实现融合知识库+API的上下文工程的解决方案
实现动态更新知识库的解决方案
实现docker镜像构建和服务器部署的企业部署解决方案
技术架构图
星通*通用智能体项目
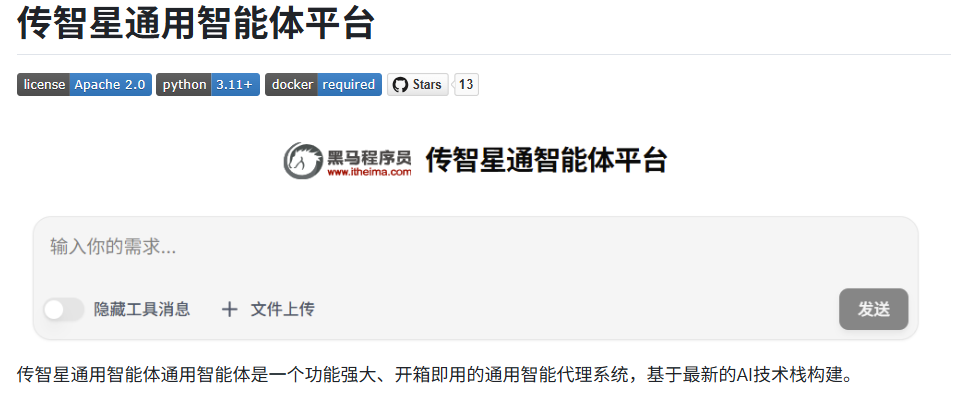
通用智能体作为该领域的高阶形态,其开发能力可为各类垂直场景的智能体构建提供坚实基础与技术范式。本项目基于 Langchain 1.0 框架,集成了 MCP 协议、多模态处理及联网搜索等前沿技术,是理解和构建复杂智能体平台的实战标杆。项目旨在构建一个基于 LangChain 生态的通用 Agent 平台,实现自主任务规划、多模态交互及联网搜索功能,支持多用户并发,具备极强的扩展性。
可掌握的核心能力
构建智能代理中枢:实现工具调用、自主任务规划及深度上下文理解。
实现全模态覆盖:支持主流办公文档(PDF/Word/Excel/PPT)及图片的双向处理。
集成实时信息检索:通过 Tavily API
实现联网搜索,确保信息的时效性与准确性。
提供企业级架构:支持多用户、多会话,提供完善的监控与追踪能力。
技术亮点
先进的技术栈:基于 LangChain v1.0,代表了当前 Agent 开发的主流趋势。
开箱即用的多模态能力:内置对多种办公文档的支持,极大降低了多模态应用的开发门槛。
高度可扩展的架构:模块化设计支持自定义工具、中间件及子代理,方便二次开发。
完善的可观测性:集成
LangSmith,提供全链路的追踪、评估和监控,确保生产环境稳定。
容器化快速部署:支持 Docker & Docker Compose,一键启动,环境一致性高。
技术架构图
微博文本信息抽取项目
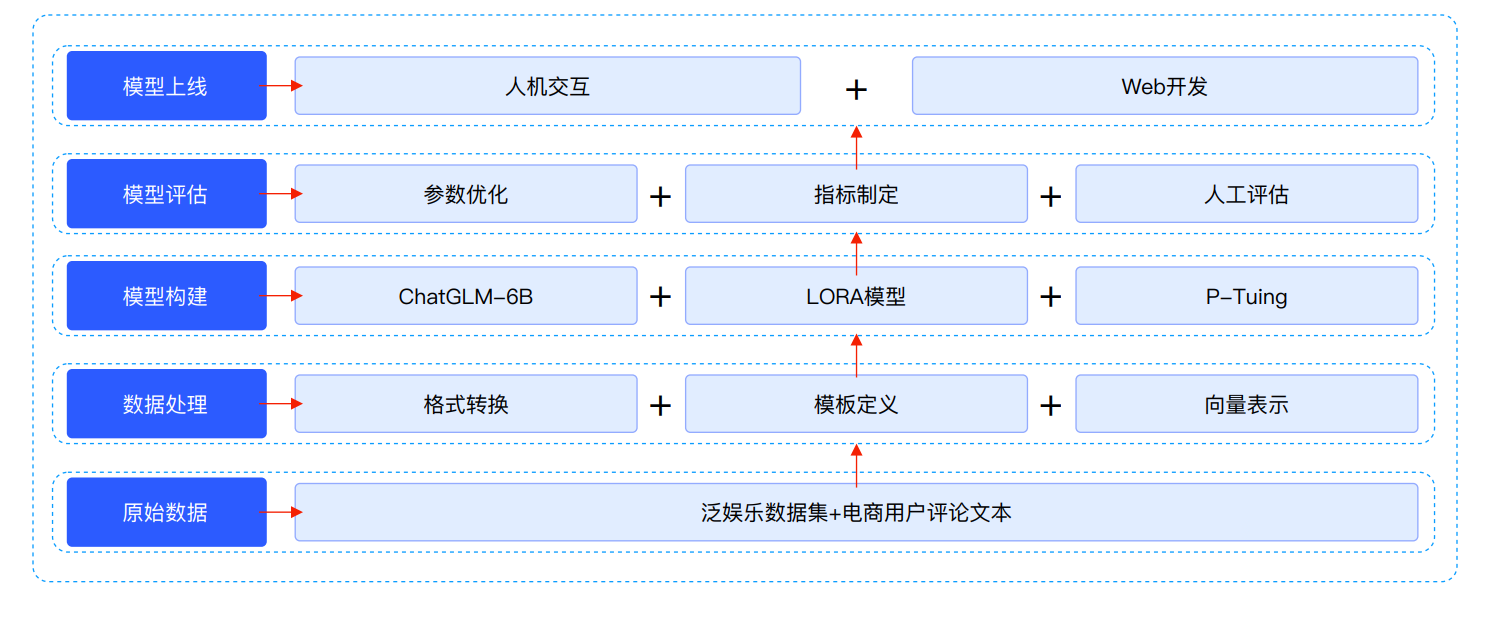
基于ChatGLM/QWen+LoRA微调实现微博文本信 息抽取+文本分类的多任务,通过一个大模型 同时解决多种任务开发和应用,项目基于LLM 进行混合任务开发应用的实现,利用 ChatGLM/QWen大模型进行P-Tuning微调的方 式,基于Flask框架实现API接口开发和应用。
可掌握的核心能力
了解和掌握大语言模型的基本原理和架构,特别是ChatGLM/QWen模型的结构和工作机制。
掌握大模型LoRA微调技术,通过微调预训练的大模型来适应特定任务的需求。
掌握大模型P-Tuning微调技术,对大模型进行高效的参数调整,增强其在特定任务上的表现。
理解和应用多任务学习的概念,通过一个模型同时解决文本信息抽取和文本分类两种任务,提高模型的综合能力和应用效率。
掌握文本信息抽取技术,从非结构化的文本数据中提取有价值的信息,如实体、关系、事件等。
学习文本分类的基本原理和方法,掌握如何将文本数据按照预定义的类别进行归类。
通过Flask框架,学习如何开发和部署API接口,使模型能够通过网络服务被访问和使用。
技术亮点
联合任务数据预处理适配模型训练的解决方案
实现ChatGLM/QWen+LoRA训练的解决方案
实现ChatGLM/QWen+P-Tuning训练的解决方案
基于Flask框架实现模型API接口开发的解决方案
技术架构图
EduRAG智慧问答系统
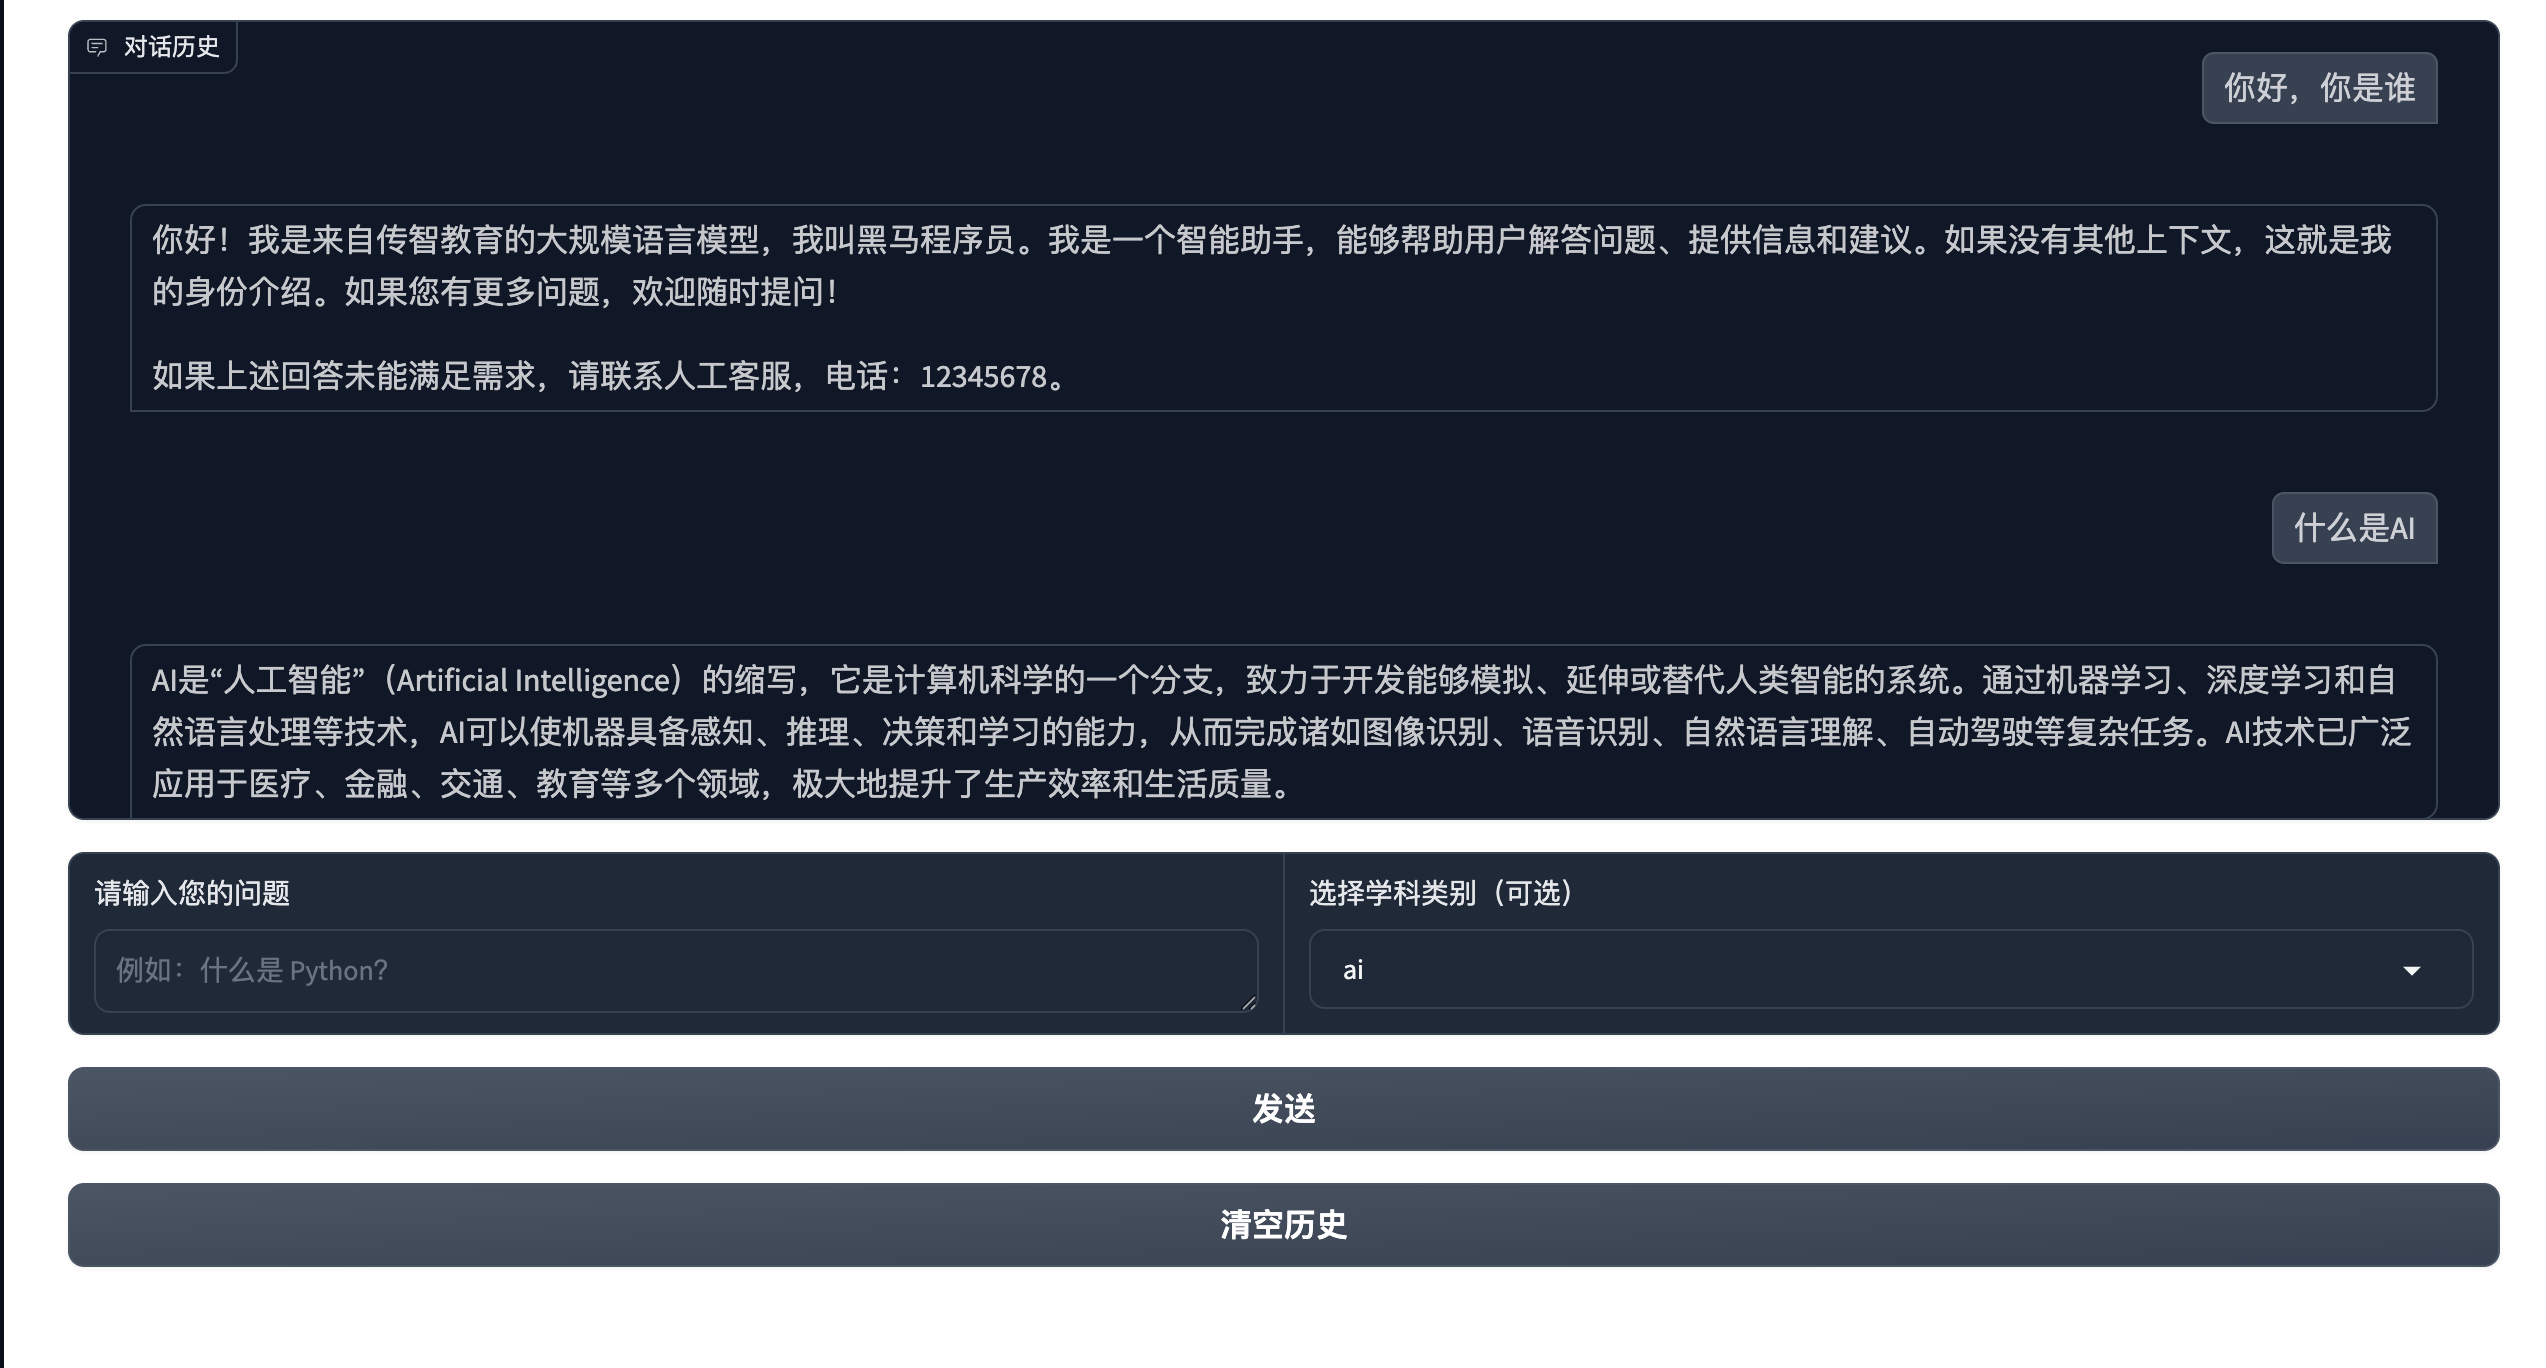
EduRAG 是一个企业级智能问答系统,专为教育场景设计,整合了基于 MySQL 的快速 FAQ 检索和基于 RAG(Retrieval-Augmented Generation)的复杂问题处理能力。系统通过结合 MySQL 数据库的高效查询和 Milvus 向量数据库的语义检索,实现了从常见问题到专业咨询的全方位问答支持。系统支持多来源过滤(如 AI、Java、测试、运维、大数据),并通过 Redis 缓存优化性能,使用 LLM 提供高质量答案生成。
可掌握的核心能力
了解LangChain基本概念、明确LangChain主要组件的作用、了解LangChain常见的使用场景
掌握基于LangChain+ChatGLM-6B模型实现本地知识库的问答实现原理+过程
RAG 系统开发与优化:掌握从数据分片到答案生成的 RAG 全流程,熟练应用
HyDE、子查询等检索增强策略提升系统性能。
大模型应用实践:能够集成 LLM(如 OllamaLLM)并设计高效
Prompt,解决知识问答中的业务定制化需求。
智能查询路由设计:实现规则、相似度和 LLM
三层路由,精准分发查询并优化复杂意图识别效率。
后端服务与前端开发:使用 FastAPI 开发高并发 API 并通过 Gradio
构建交互界面,满足企业级服务与用户体验要求。
数据处理与多源集成:熟练处理结构化与非结构化数据,结合 MySQL
和向量搜索打造高效知识检索系统。
企业级问题解决能力:通过日志调试和高并发设计,具备定制化开发与性能优化的实战技能,适配智能客服等场景。
技术亮点
数据库查询优化:BM25 + Redis 缓存
语义检索:Milvus 混合向量检索
查询分类:BERT 分类器
动态检索策略:LLM 驱动的策略选择(直接检索、HyDE、子查询、回溯)
答案生成:LLM + RAG 提示模板
性能优化:Redis 缓存 + 模块化设计
日志与监控:统一日志系统(logging)
配置管理:ConfigParser + config.ini
技术架构图
EduAgent多智能体项⽬
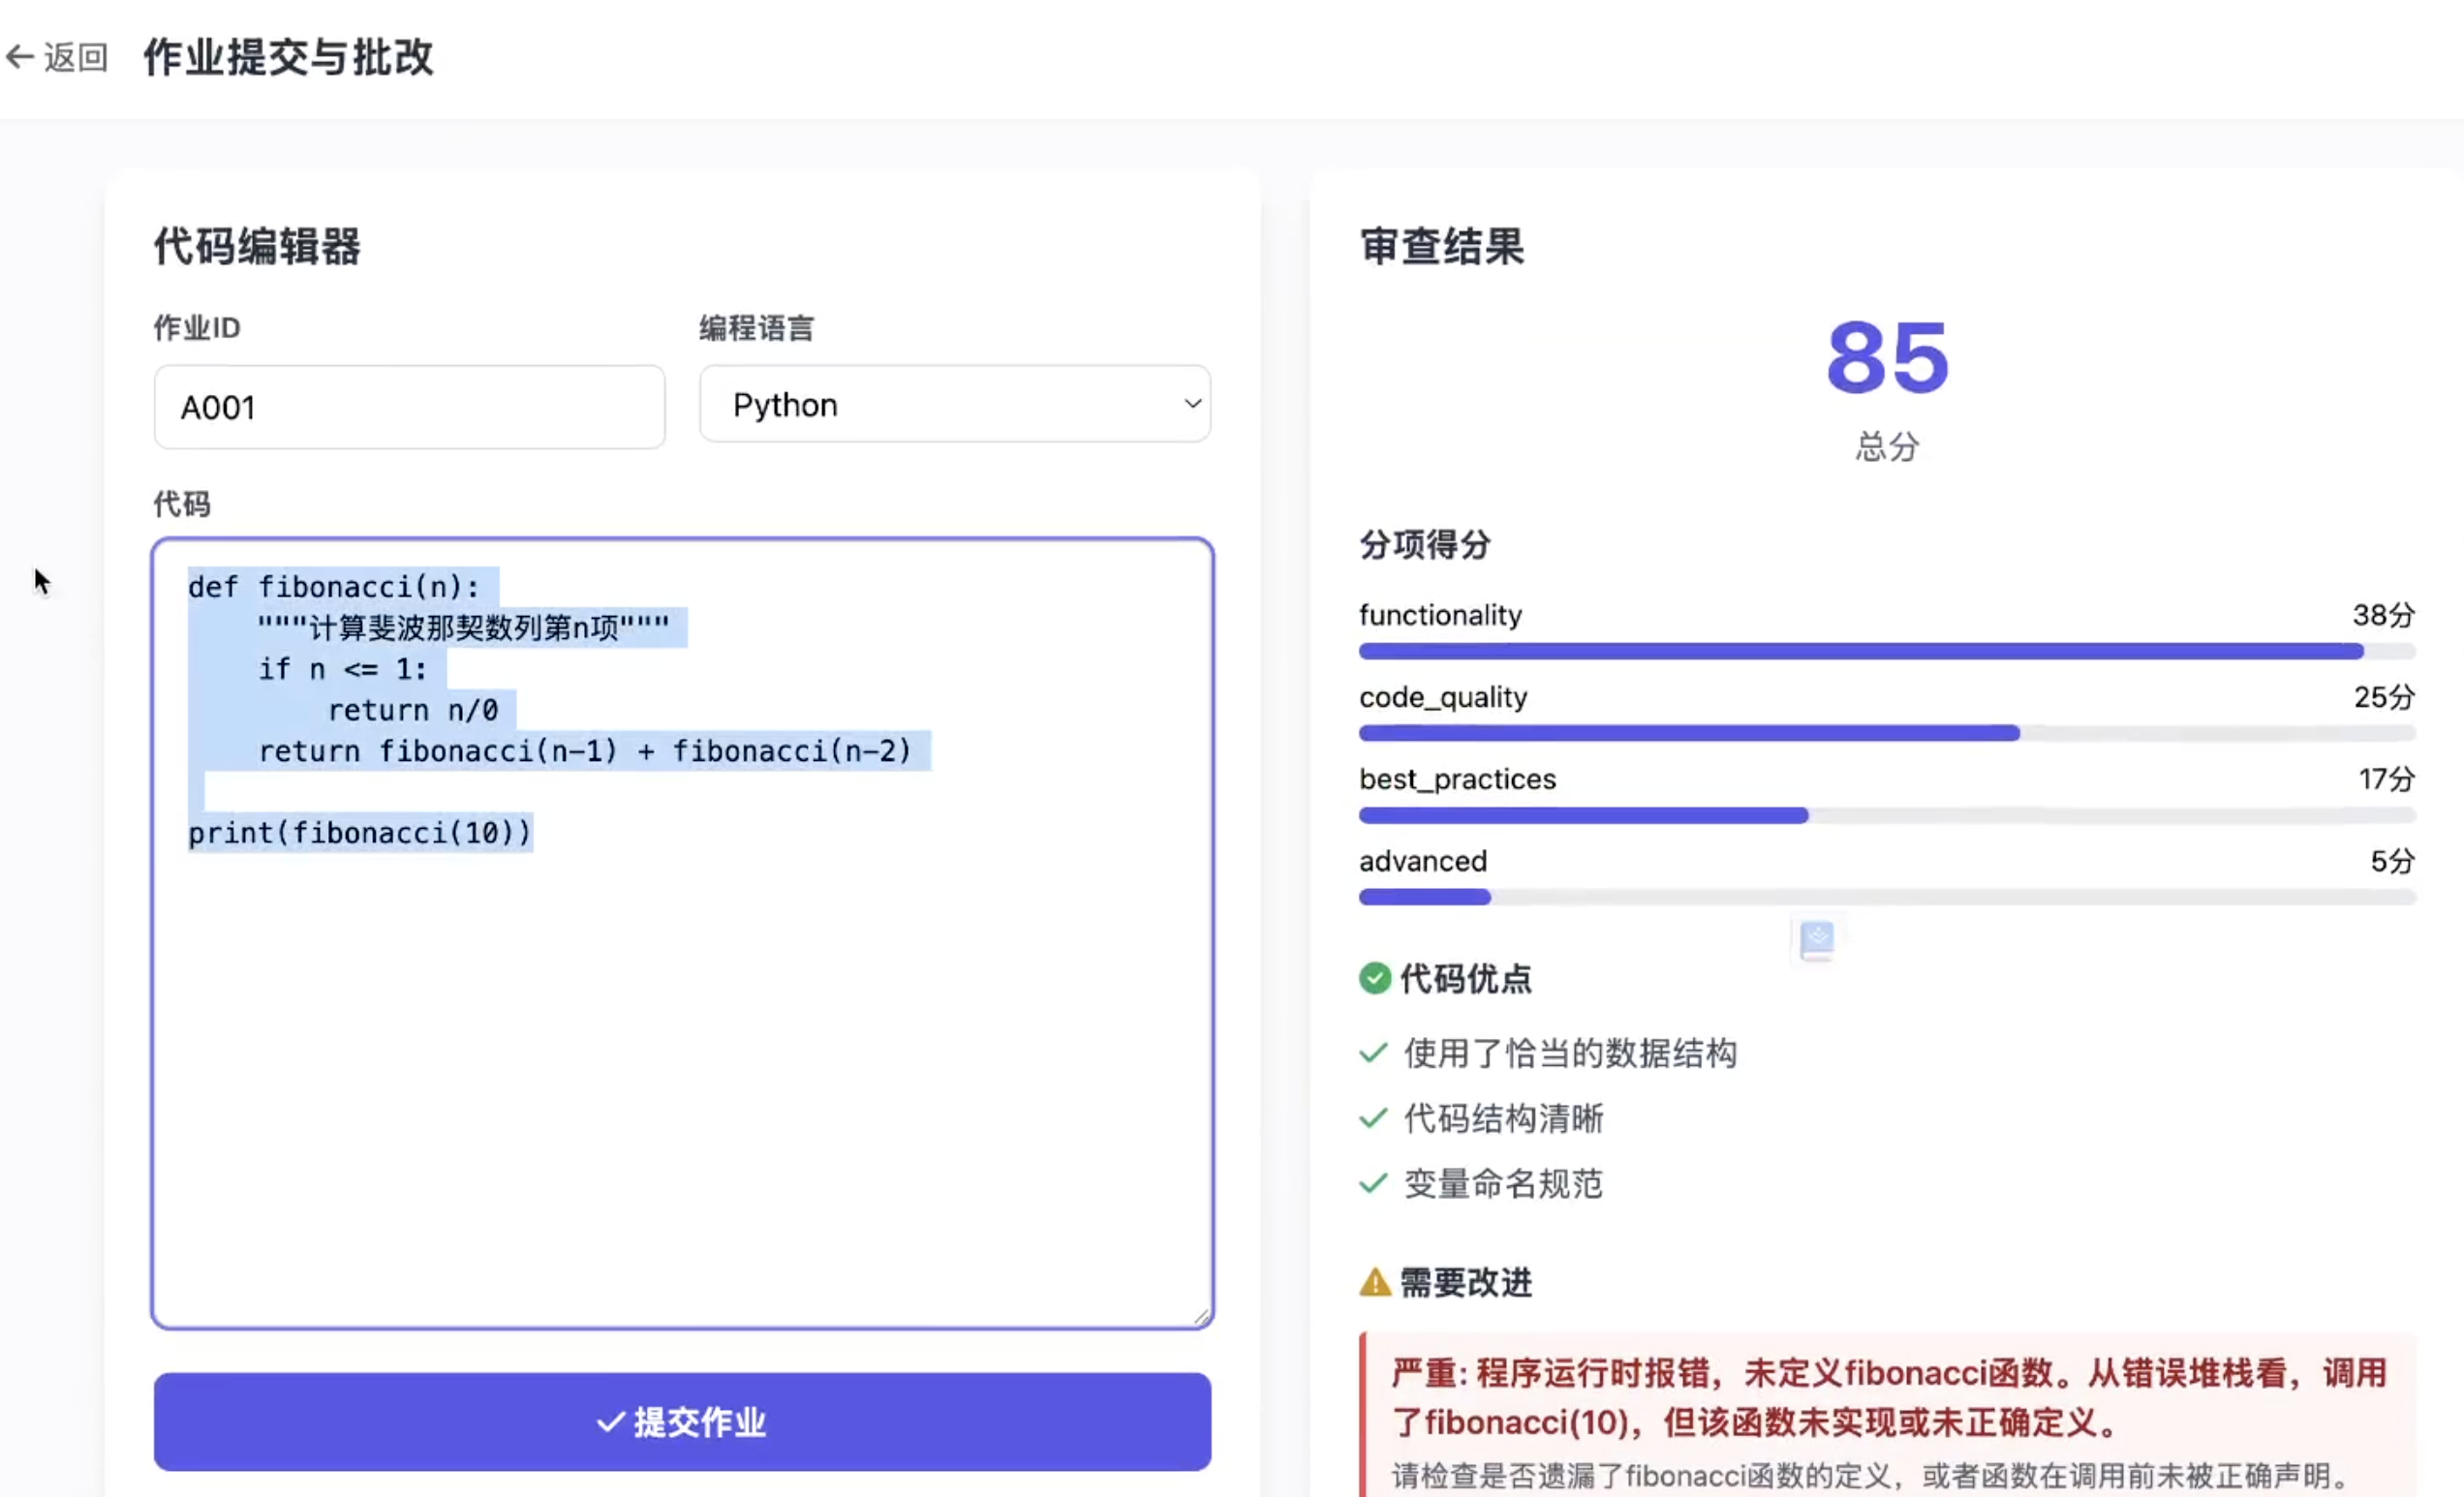
EduAgent项目基于LangChain、LangGraph和FastAPI构建。系统提供智能问答、代码审查、个性化学习路径规划和职业咨询等核⼼功能,旨在为在线教育场景提供全⽅位的AI辅助教学解决⽅案
可掌握的核心能力
基础设施:⼀键docker-compose启动全环境,PostgreSQL、Milvus、Redis、MinIO、
Judge0 全部就绪
公共能⼒层:LLM
Factory多模型路由、BGE-Reranker精排、MiniLM意图分类,全部可独⽴调⽤
四⼤Agent:智能问答、试卷批改、简历审查、模拟⾯试,端到端流程完整跑通,异常处理与降级策略覆盖到位
前端集成:Vue3界⾯与后端API全⾯对接,SSE流式输出流畅,三级⻆⾊权限路由隔离完整
集成测试:核⼼流程覆盖率达标,三层兜底降级机制验证通过,并发压测⽆崩溃
技术亮点
教育场景多租户数据隔离解决⽅案:所有PostgreSQL表预埋tenant_id,Milvus
Collection按租户namespace隔离,⽀持多班级、多课程独⽴运营
⾼精度RAG冷启动与持续迭代解决⽅案:初始知识库由课程资料清洗⼊库,检索链路采⽤混合召回+精排+置信度过滤,低置信度问答⾃动进⼊补充队列,教师在线添加后热更新知识库
复杂批改任务的三轨并⾏加速解决⽅案:试卷批改Agent中,客观题规则引擎、简答题LLM分组并⾏、代码题Judge0执⾏+LLM评估三条轨道通过asyncio.gather并发执⾏,整体批改耗时降低60%以上
Human-in-the-Loop教师确认解决⽅案:利⽤LangGraph的interrupt()挂起批改结果,教师登录后逐题确认或修改,通过Command恢复图执⾏,并集成企业微信机器⼈⾃动推送待确认通知
国产模型低成本切换与降级解决⽅案:LLM Factory封装DeepSeek-V3(通⽤)和
DeepSeek-Coder-V2(代码),⽀持配置热切换;三层兜底机制(重试→降级模型→预设回复)保障LLM服务异常时的系统可⽤性
本地开发到⽣产环境的平滑迁移解决⽅案:本地使⽤Docker Compose +
MemorySaver+MinIO,⽣产环境仅需修改配置(AsyncPostgresSaver、阿⾥云
RDS/OSS、K8s 部署),业务代码零改动,⽀持⼀键迁移
技术架构图

基于亚马逊电商商品聚合大模型项目
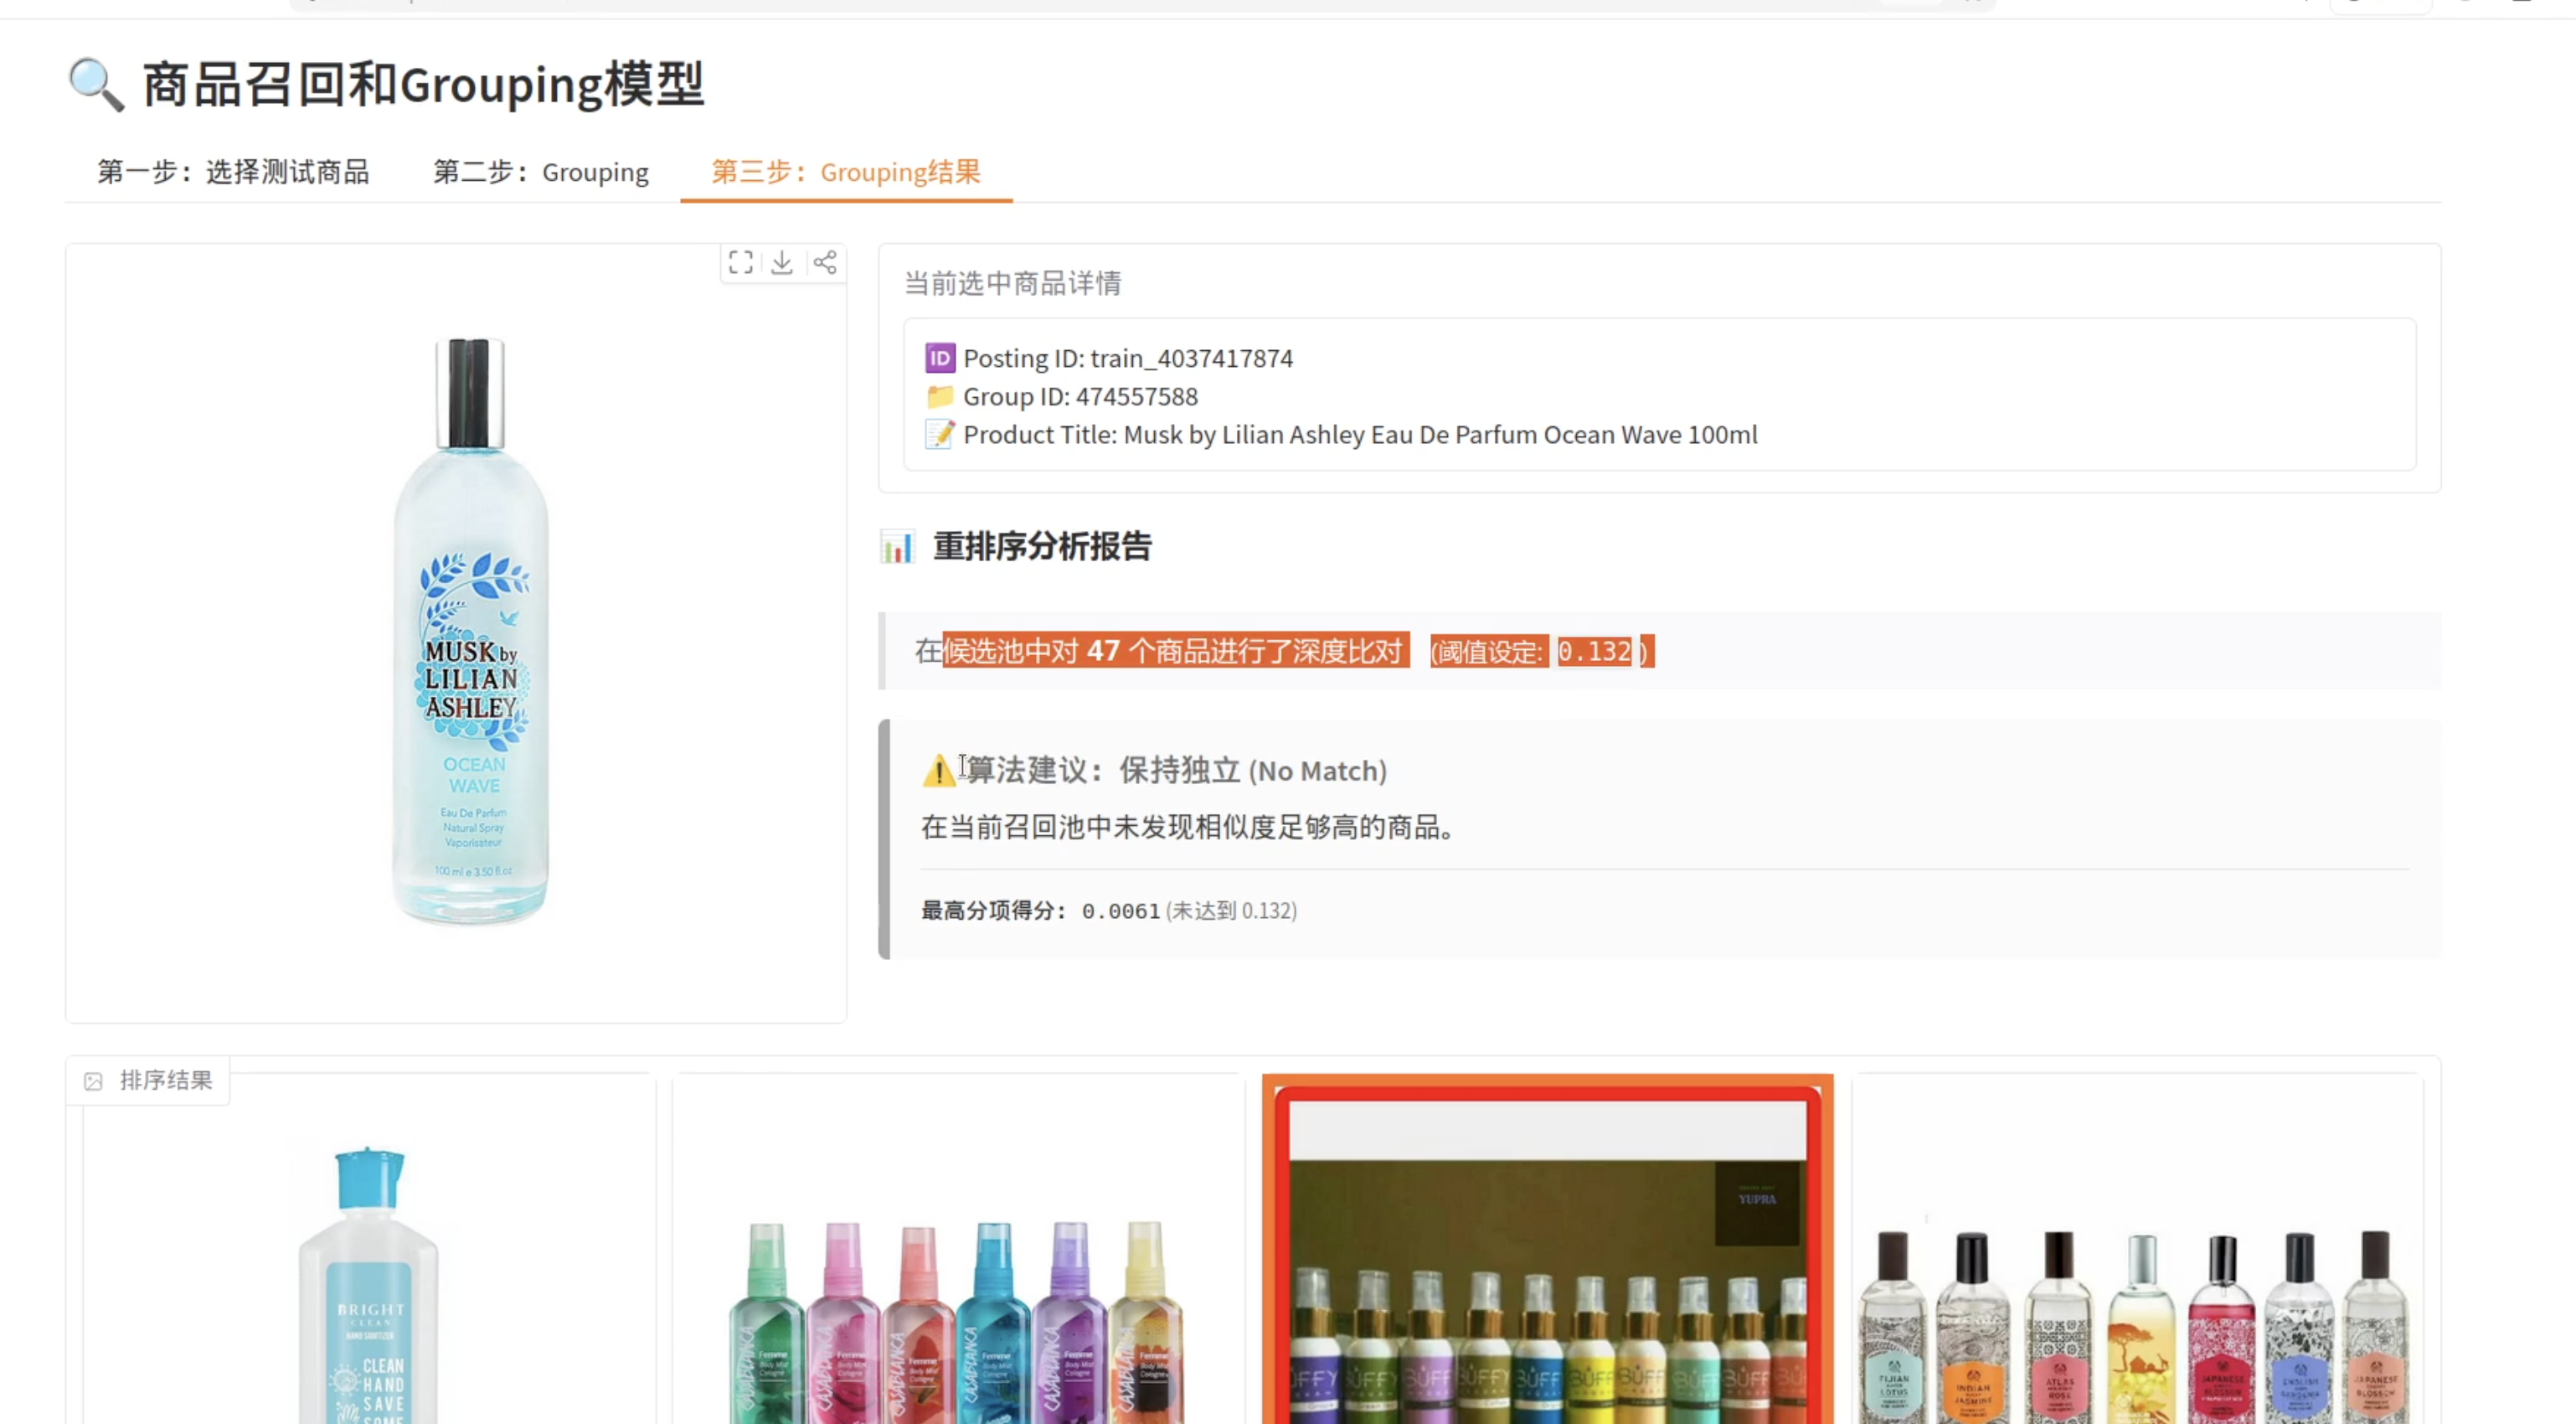
项⽬以“电商商品聚合与⽐价”为核⼼业务场景,解决电商场景中多源、异构商品数据的标准化处理、⾼精度分类与智能聚合难题
可掌握的核心能力
环境与⼯程搭建能⼒:熟练搭建Linux开发环境,吃透模型微调完整流程,精通PyTorch
与HuggingFace⽣态,具备⼯业级算法项⽬搭建基础能⼒
电商数据处理能⼒:掌握电商商品数据集制作、⼤模型少样本预标注、主动学习降本、难负样本挖掘,独⽴完成业务数据清洗与优化
多模态模型微调能⼒:精通商品分类、向量召回、同款聚合聚类三⼤任务,熟练运⽤对⽐学习、度量学习、LoRA⾼效微调,可独⽴微调图⽂多模态模型
主流算法与⼯具实战能⼒:掌握双塔/交叉编码器架构、FAISS向量检索、⾃动超参调优,能⽤LlamaFactory实战微调视觉⼤模型,⾃定义训练逻辑与评估指标
模型推理部署落地能⼒:掌握模型量化、推理加速、注意⼒优化,可快速搭建交互式演示项⽬,完成多模态⼤模型从训练、调优到线上部署全流程落地
技术亮点
低成本⾼质量数据集构建解决⽅案
使⽤Optuna进⾏⾃动超参数寻优解决⽅案
多模态⼤模型微调解决⽅案
多模态⼤模型推理部署解决⽅案
多模态⼤模型推理优化解决⽅案
技术架构图
黑马直聘·基于LoRA微调和强化学习的人力资源搜索引擎项目
基于⼈⼒资源招聘⾏业垂直⼤模型与知识图谱融合检索解决⽅案,通过项⽬学习完成企业级招聘检索系统全流程开发、部署、测试与优化。从Transformer底层原理、⼤模型 SFT+DPO双阶段微调、LangGraph智能体构建、招聘职位实体要素抽取及图谱关系构建,结合实时数据⼯程组件写⼊职位实体到检索引擎,完成招聘AI检索系统构建
可掌握的核心能力
招聘领域⼤模型微调能⼒
⼤模型服务化部署能⼒
LangGraph 智能体开发能⼒
招聘知识图谱构建能⼒
搜索意图识别匹配能⼒
Kafka+Flink实时数据流处理能⼒
基于Kafka消息队列实现业务解耦能⼒
搜索推荐(Sug)构建能⼒:基于实体图谱的搜索词补全
技术亮点
招聘领域⼤模型 SFT+DPO 双阶段微调解决⽅案
基于 LangGraph 的招聘智能体与知识图谱构建解决⽅案
招聘搜索意图识别与实体抽取解决⽅案
⼤模型 vLLM ⾼性能推理部署解决⽅案
ElasticSearch+Redis ⾼并发职位检索解决⽅案
基于实体图谱的搜索词推荐(Sug)解决⽅案
⼤模型训练显存优化(ZeRO / 梯度检查)解决⽅案
招聘检索 badcase 治理与相关性优化解决⽅案
技术架构图